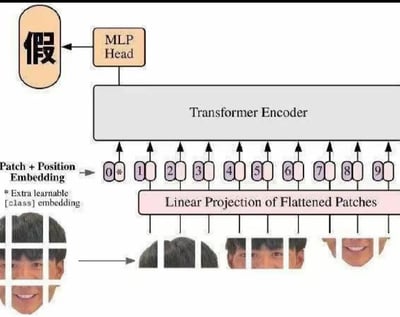
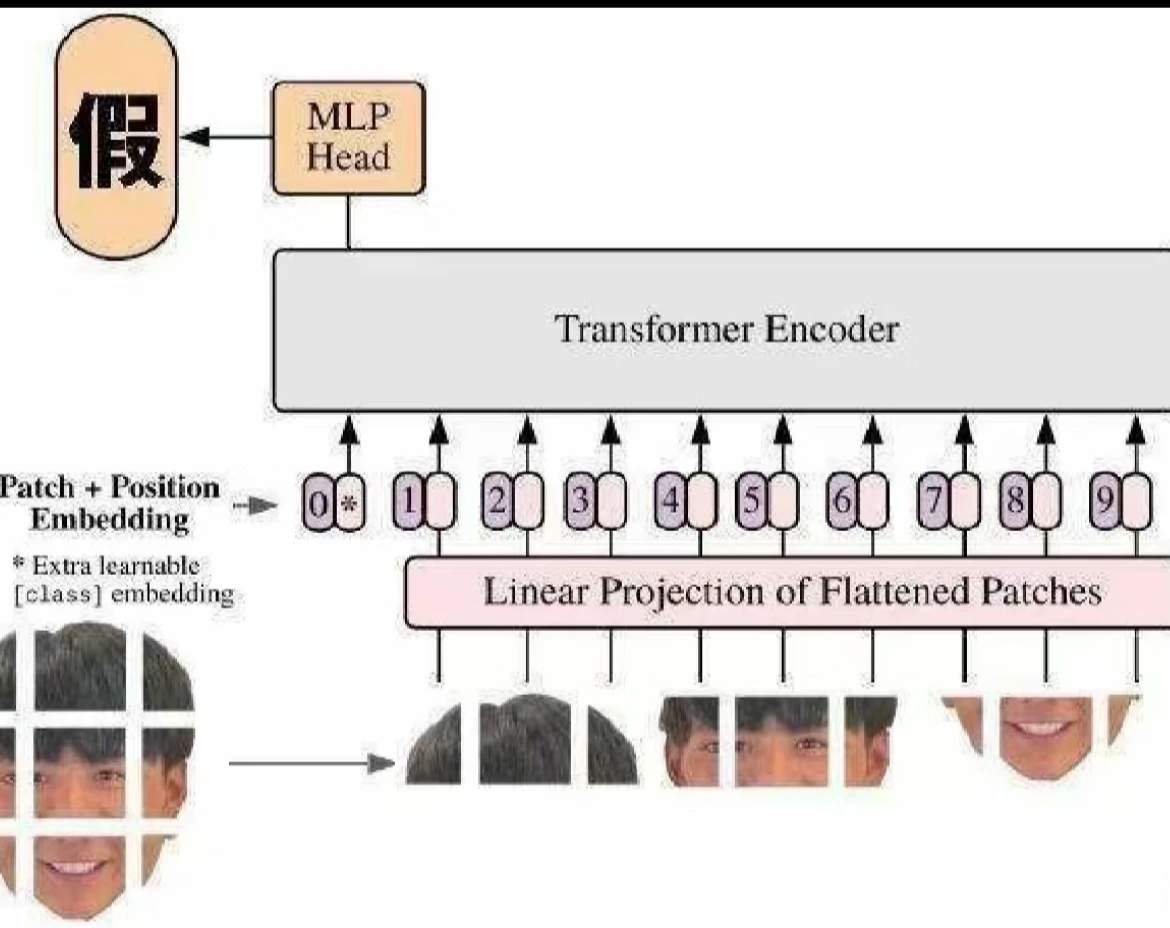
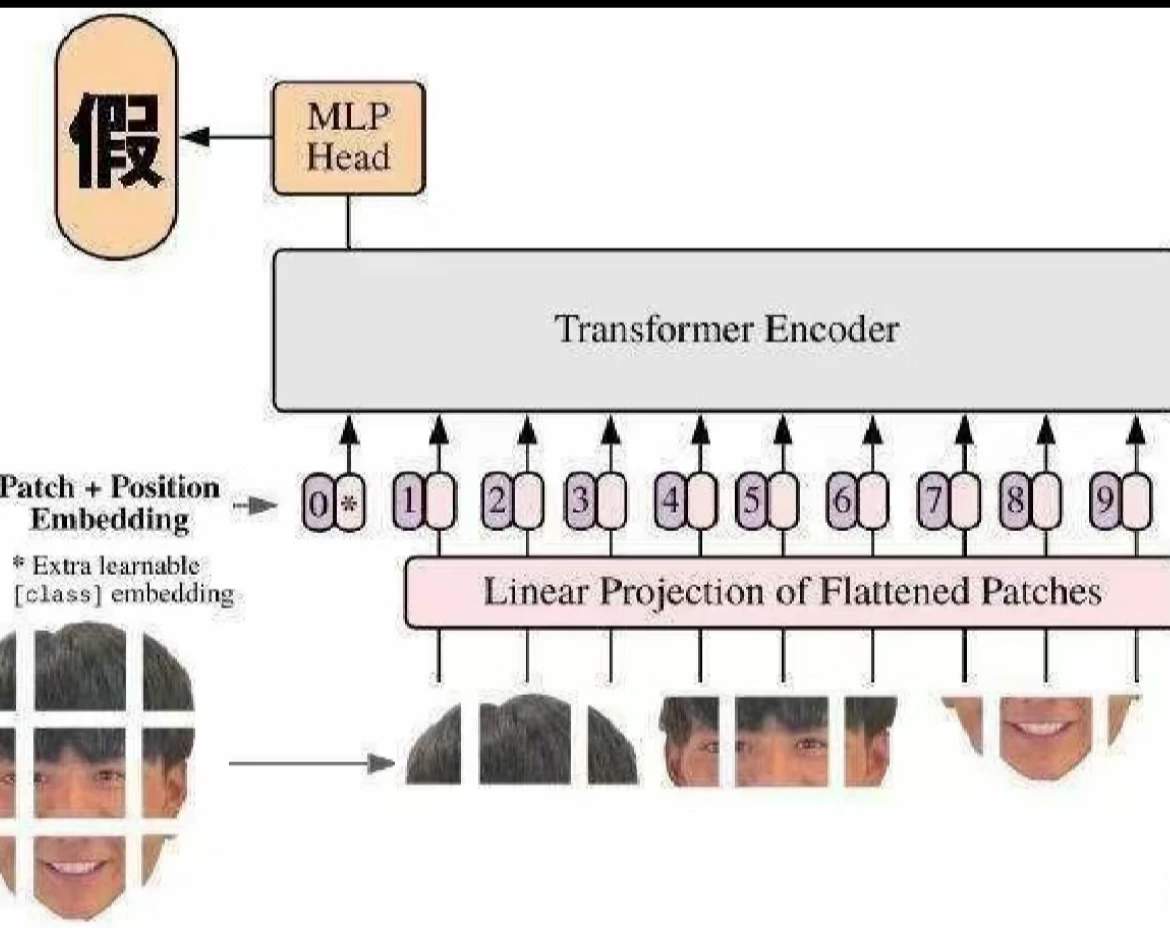
基于Vision Transformer的伪造人脸检测模型架构图

这张图详细展示了一个基于Vision Transformer(ViT)的伪造人脸检测模型的完整工作流程:
1. 输入阶段:将原始人脸图像分割为多个规则的图像块(Patch);
2. 预处理阶段:对每个分块图像进行展平后的线性投影(Linear Projection of Flattened Patches),再添加额外的可学习[class]嵌入(标记为0*的特殊嵌入)和位置嵌入(Patch + Position Embedding),生成序列化的嵌入向量;
3. 特征编码阶段:将嵌入向量序列输入到Transformer Encoder中进行全局特征提取;
4. 输出阶段:通过MLP Head(多层感知机头部)输出检测结果“假”,完成对伪造人脸的识别。
图中用具体的人脸分块示例直观呈现了从原始图像到模型输入的转换过程,清晰解释了ViT架构在伪造人脸检测任务中的应用逻辑。

文本内容

假
MLP Head
Transformer Encoder
Patch + Position Embedding
* Extra learnable [class] embedding
Linear Projection of Flattened Patches

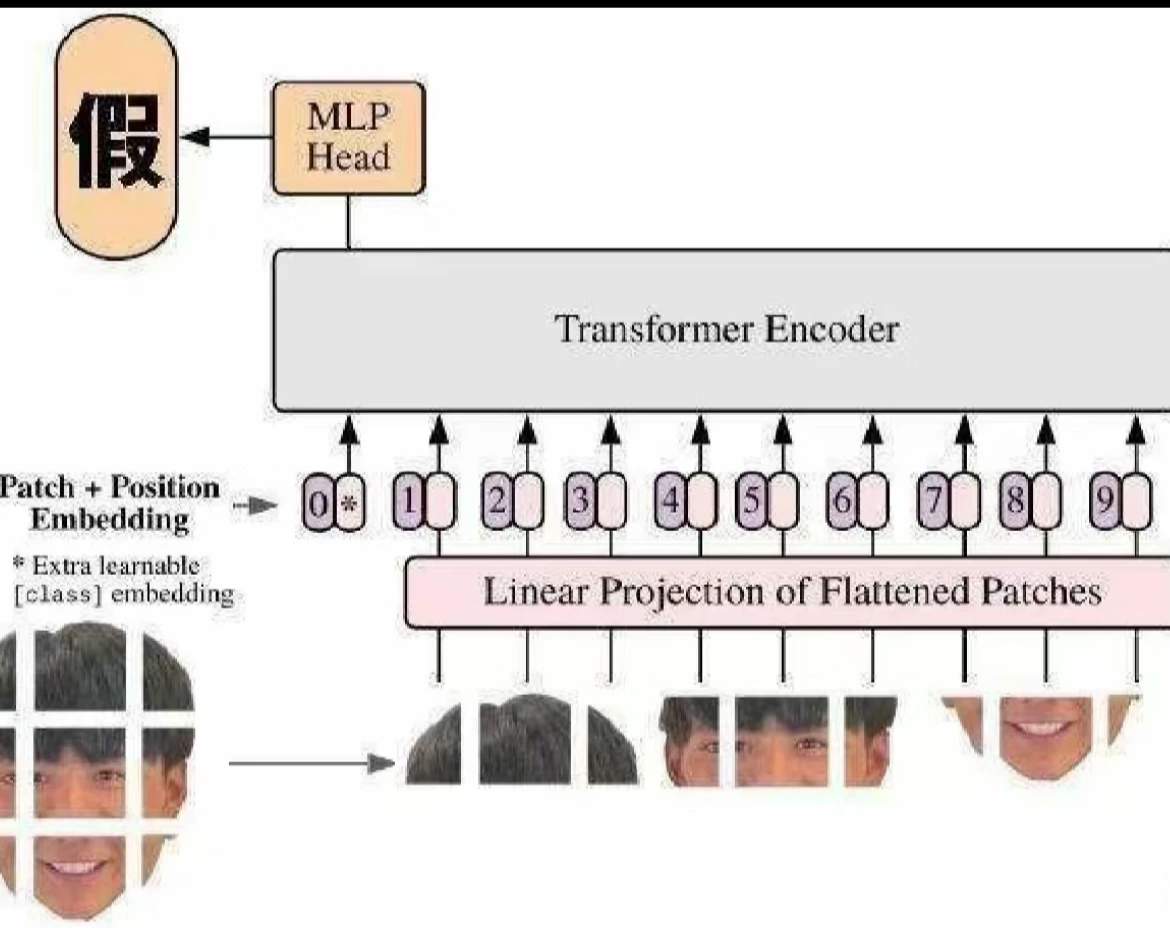
整体描述

这张图详细展示了一个基于Vision Transformer(ViT)的伪造人脸检测模型的完整工作流程:
1. 输入阶段:将原始人脸图像分割为多个规则的图像块(Patch);
2. 预处理阶段:对每个分块图像进行展平后的线性投影(Linear Projection of Flattened Patches),再添加额外的可学习[class]嵌入(标记为0*的特殊嵌入)和位置嵌入(Patch + Position Embedding),生成序列化的嵌入向量;
3. 特征编码阶段:将嵌入向量序列输入到Transformer Encoder中进行全局特征提取;
4. 输出阶段:通过MLP Head(多层感知机头部)输出检测结果“假”,完成对伪造人脸的识别。
图中用具体的人脸分块示例直观呈现了从原始图像到模型输入的转换过程,清晰解释了ViT架构在伪造人脸检测任务中的应用逻辑。

来源说明

该图是基于谷歌2020年提出的Vision Transformer(ViT)基础模型,针对伪造人脸检测任务进行适配的技术架构图。这类架构图通常出现在计算机视觉领域的学术论文、技术博客、机器学习教程中,用于讲解ViT模型在人脸伪造检测任务中的具体实现流程,一般由相关领域的研究者、技术人员使用专业绘图工具(如Figma、Visio、Draw.io等)制作,常见于arXiv、知乎技术专栏、CSDN等技术分享平台。
相似的梗图

用玩梗方式解释ViT模型:人脸当输入的搞笑示意图

这张图用玩梗的方式调侃视觉Transformer(Vi...

棉花玩偶变形恢复教程

这是一张指导买家恢复变形棉花玩偶的教程图文,首先说明因...

共形变换与拟共形变换的人脸映射对比

这是一张用于微分几何教学的专业对比图示,通过3D渲染的...

耗时两天制作的散落头发假人头模型

这是一张原始拍摄的静态图,画面主体为一个白色泡沫材质的...

Otto图像变换搞笑梗图

这是一张搞笑梗图,通过模仿编程代码的形式展示对名为"o...

编辑软件中的表情变形过程展示

图片展示了一个编辑软件的界面,顶部为字体格式工具栏,包...

长期固定发型分缝的夸张后果示意图

这是一张图文混排的连环静态图,上方配有提示文字“缝要经...

meme梗图:假装翻找未动笔的作业

这是一张图文混排的梗图,采用顶配底文的结构,顶部深蓝色...

不同称呼求AI翻译的反差回应

这是一个三段式的模拟AI聊天拼贴图,展示用户用三种不同...

《来自深渊》官方角色眼睛设定集合

这是日本漫画家土笔章人创作的《来自深渊》相关画集《DA...

卡通老人伸手说'修但幾勒'

一张黑白卡通风格的图片,描绘了一位白发老人面带微笑,伸...

“学数学学的”刻板印象演变概况

这是一张以时间线为脉络的多图拼接梗图,展示了1980年...

梗图网

梗图网

打开手机 App,找梗更快

下载